智能音箱与智能闹钟语音交互技术解析:从拾音算法到场景联动的完整方案
过去两年,带屏智能音箱出货量增速放缓,而带语音交互的智能闹钟品类却逆势上扬。背后的逻辑并不复杂:用户对"能对话的设备"已经脱敏,真正愿意买单的是在特定场景下唤醒成功率高、响应延迟低、联动逻辑清晰的产品。这恰恰考验的是从麦克风阵列到云端语义、再到本地设备协同的全链路能力。
拾音前端:被低估的工程门槛
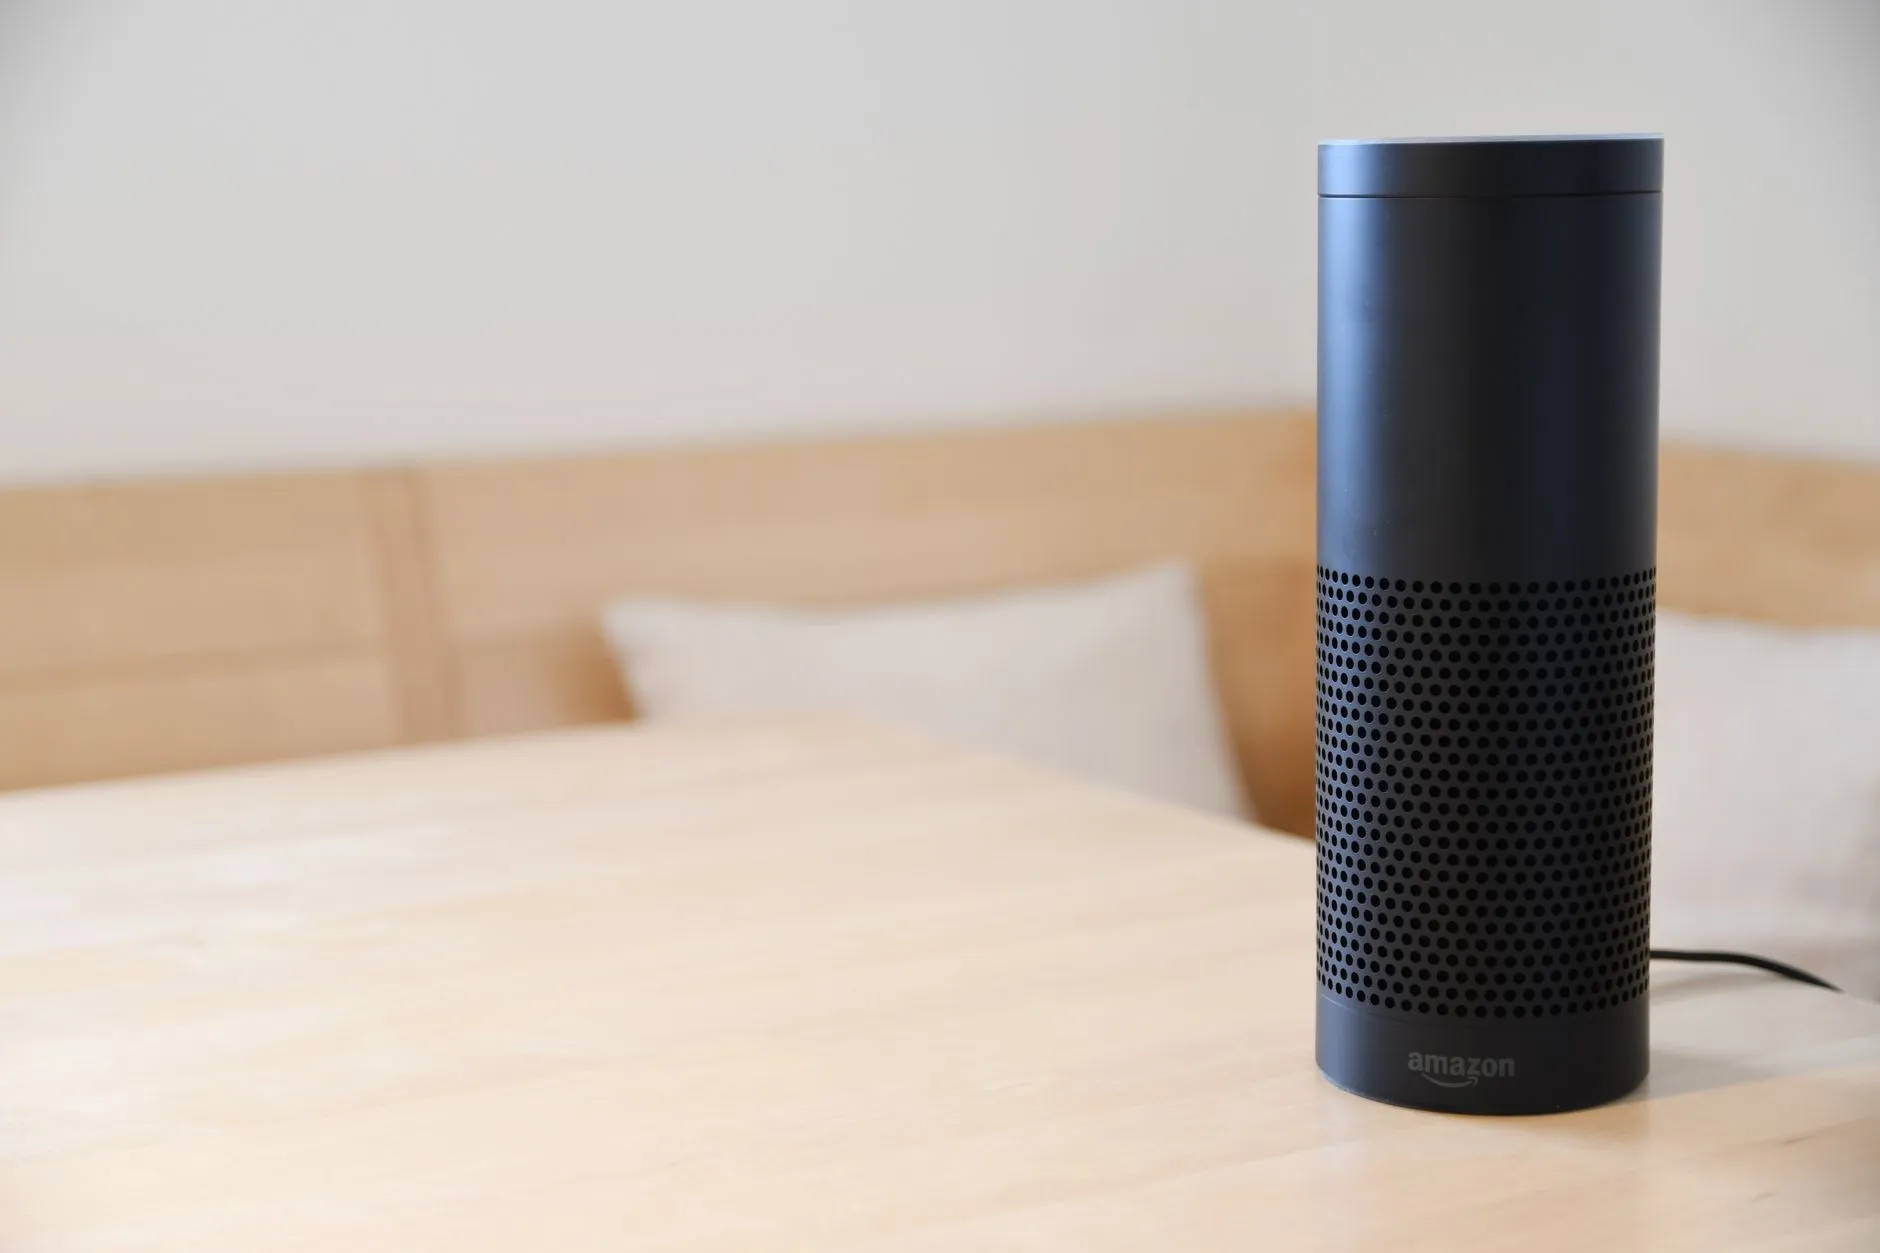
很多团队在开发智能闹钟时,习惯直接套用智能音箱的拾音方案,结果在卧室场景下频频翻车。卧室的声学环境远比客厅复杂——床头软包、窗帘、被褥构成强吸声面,而设备往往放置在离人耳不到50厘米的位置,近场反射与远场混响叠加,导致波束成形算法容易将人声误判为噪声。
成熟的做法是采用双麦克风差分拾音+自适应噪声抑制:一颗麦克风朝向用户方向拾取人声主信号,另一颗朝外采集环境噪声,通过LMS自适应滤波实时抵消。配合VAD(语音活动检测)的动态阈值调整,可将误唤醒率控制在24小时不超过1次的水平。对于智能音箱而言,通常需要4-6麦环形阵列来实现360°拾音,而智能闹钟更强调定向灵敏度,这是两类产品在硬件选型上的根本分野。
从唤醒到执行:场景联动的时序控制
语音交互的"最后一公里"不在识别率,而在联动执行的确定性。用户说"晚安",设备需要同时完成:关闭智能灯、将智能插座断电、启动智能摄像头布防、设定次日智能闹钟。这四个动作如果走云端串行下发,端到端延迟可能超过2秒,体验上就是"说完之后设备愣了一会儿才动"。
更合理的架构是本地场景引擎+云端语义兜底。设备端预置常用场景的自动化规则,语音指令经本地NLU解析后直接触发局域网内的Zigbee或Wi-Fi设备,响应时间可压到300毫秒以内。只有涉及复杂条件判断(如"如果明早下雨就推迟闹钟")时才上云处理。这种分级策略在智能音箱与智能闹钟的协同中尤为关键——音箱负责远场拾音和复杂语义,闹钟负责近场唤醒和本地执行,各司其职。
实践中的三个工程建议
- 唤醒词与命令词分离训练:将唤醒模型和命令词识别模型分开部署,避免因命令词扩充导致唤醒率下降。实测中,分离训练可使唤醒率提升约7个百分点。
- 智能插座与智能灯的联动优先级:灯光渐灭和插座断电应设置50-100ms的时间差,避免继电器动作噪声被麦克风二次拾取造成误触发。
- 智能摄像头的隐私时序:布防指令下发后,摄像头应延迟3-5秒再启动录制,给用户留出"反悔窗口",这是产品伦理层面的细节。
另一个容易被忽视的细节是回声消除的收敛速度。智能闹钟在播放白噪音或助眠音乐时,如果AEC收敛不够快,用户中途说"关掉"会被自己的播放声掩盖。当前主流方案采用分块频域自适应滤波,收敛时间可做到80ms以内,基本满足打断式交互的需求。
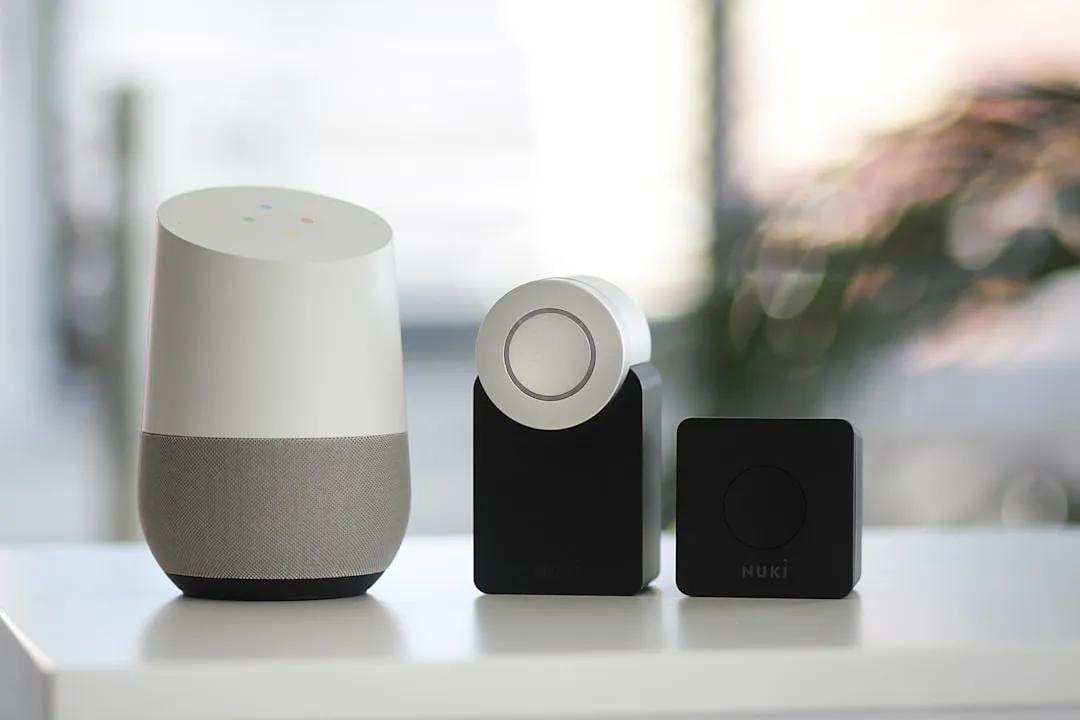
从趋势看,语音交互正在从"单设备智能"走向"空间智能"。智能音箱、智能闹钟、智能灯、智能插座、智能摄像头不再是各自为战的单品,而是共享一套拾音-理解-执行管线的空间节点。谁能把端到端延迟做到500ms以内、把误唤醒压到可忽略的水平,谁就能在下一轮智能家居入口争夺中占据身位。成都万感空间数字科技有限公司持续在拾音算法与场景联动引擎上投入研发,为行业客户提供从模组到完整方案的灵活选择。